La clave está en coordinar mejor miles de procesadores y evitar que trabajen a máxima potencia cuando no es necesario. NVIDIA ya estudia incorporar esta tecnología.
- ⚡ Hasta un 50 % menos de energía: la combinación de ambas tecnologías permite aprovechar mejor los recursos informáticos.
- 🖥️ Sin cambiar los procesadores: el ahorro procede de modificar su velocidad de funcionamiento y organizar las tareas.
- 🔧 Perseus: reduce hasta un 30 % el consumo ajustando la velocidad de las GPU para evitar trabajo innecesariamente rápido.
- 🧠 Kareus: consigue ahorros adicionales del 10 % al 30 % mediante una planificación más eficiente de los cálculos y las comunicaciones.
- 🌍 NVIDIA estudia su integración: los investigadores trabajan para incorporar estas optimizaciones a Megatron-LM, una plataforma abierta para entrenar grandes modelos de lenguaje.
El crecimiento de la inteligencia artificial está planteando un importante desafío energético. Entrenar modelos cada vez más grandes requiere miles de procesadores trabajando simultáneamente, pero una parte de la electricidad consumida se desperdicia debido a la forma en que se distribuyen y coordinan las tareas.
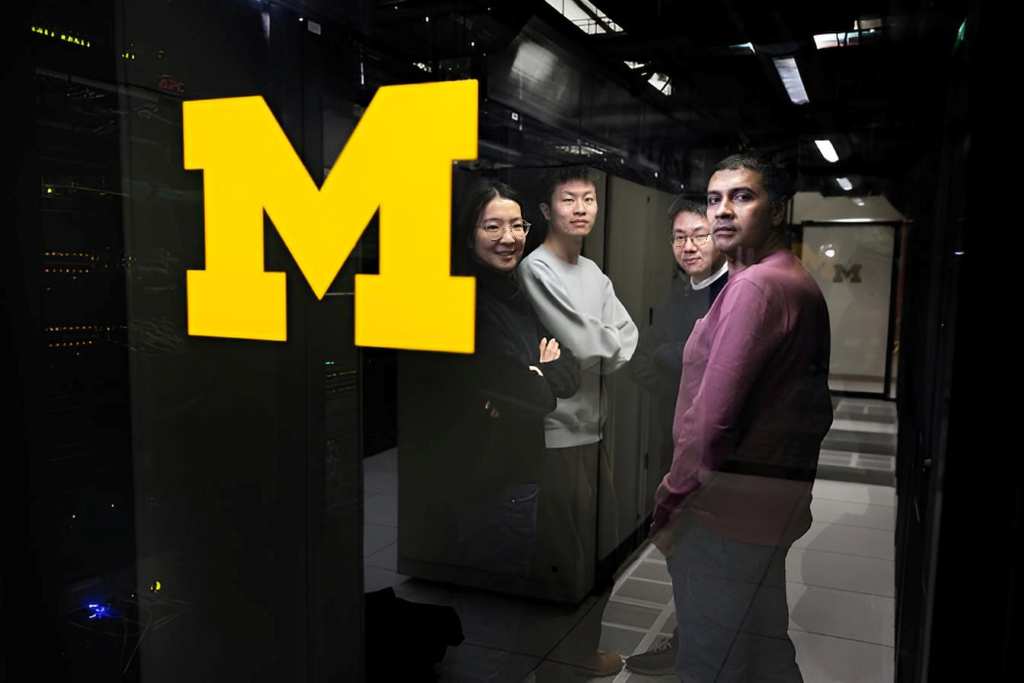
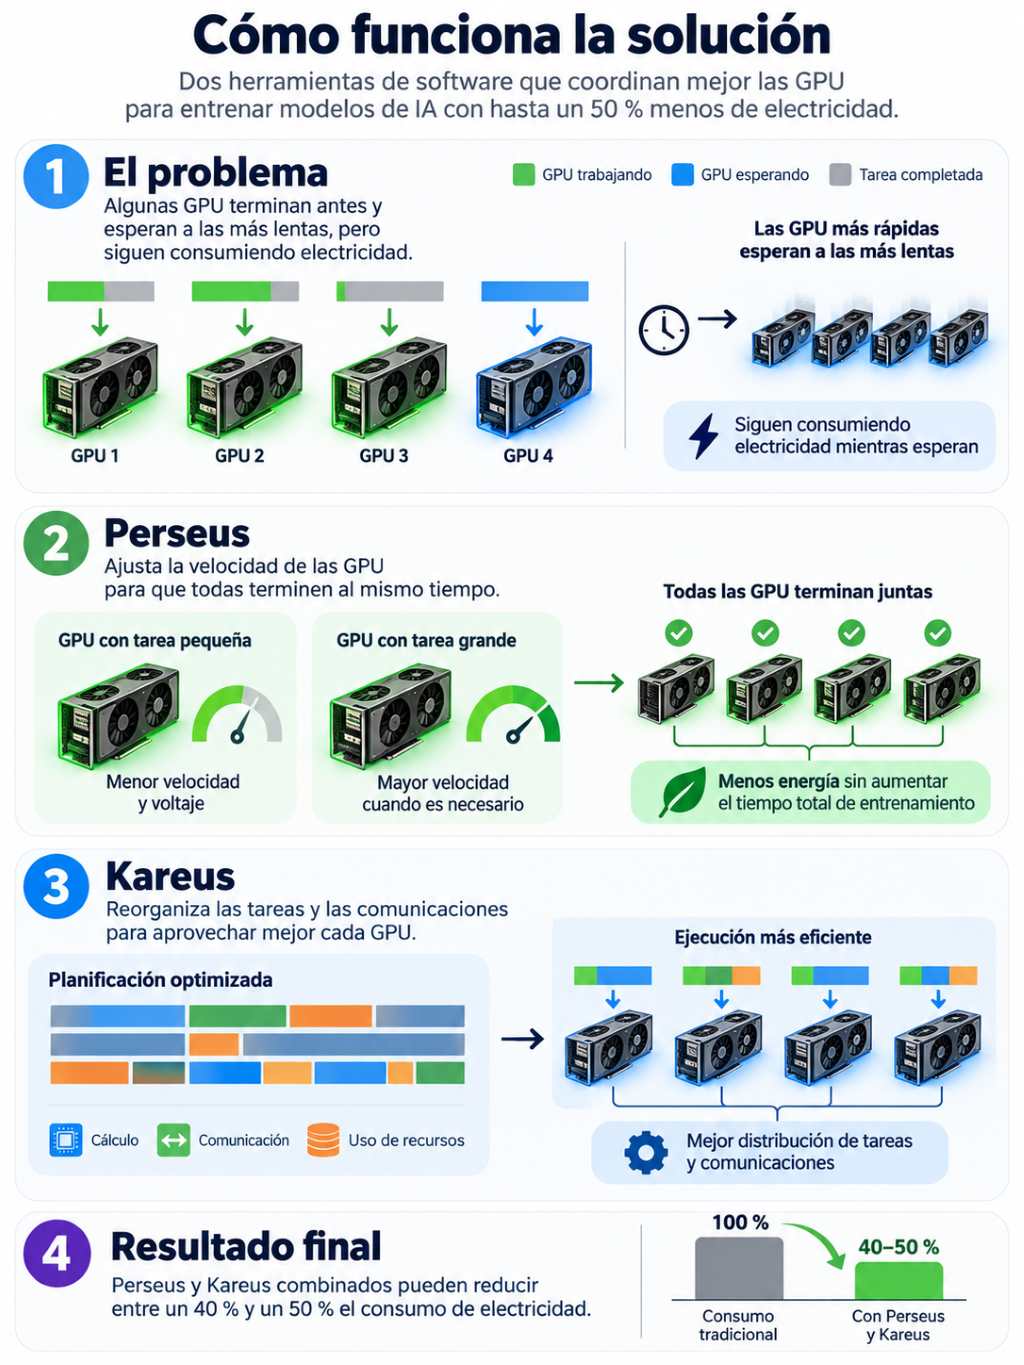
Un equipo de ingenieros de la Universidad de Michigan (Estados Unidos) ha desarrollado dos herramientas de software, denominadas Perseus y Kareus, que permiten optimizar ese proceso. Combinadas, podrían reducir entre un 40 % y un 50 % el consumo energético del entrenamiento de grandes modelos de IA, manteniendo su velocidad y rendimiento.
El problema energético de entrenar inteligencia artificial
El entrenamiento de los grandes modelos de inteligencia artificial se basa en una técnica conocida como procesamiento paralelo.
En lugar de utilizar un único procesador, los sistemas distribuyen enormes cantidades de datos y operaciones matemáticas entre cientos o miles de unidades de procesamiento gráfico, conocidas como GPU.
Estas unidades trabajan simultáneamente para calcular los parámetros del modelo, intercambiar información y actualizar sus resultados.
Sin embargo, existe un problema de coordinación.
No todas las GPU necesitan el mismo tiempo para completar su trabajo. Algunas terminan antes que otras y deben esperar hasta que las más lentas concluyan sus operaciones.
Durante esas esperas, los procesadores pueden haber consumido más electricidad de la necesaria para completar su parte del entrenamiento.
El equipo dirigido por el profesor Mosharaf Chowdhury identificó que buena parte de estas ineficiencias podía corregirse mediante software, sin necesidad de modificar físicamente los equipos.
Perseus: reducir la velocidad de los procesadores para ahorrar electricidad
La primera herramienta, denominada Perseus, fue presentada en una investigación publicada en 2024.
Su funcionamiento se basa en una idea sencilla: no siempre es necesario que todos los procesadores trabajen a máxima velocidad.
Cuando una GPU tiene una tarea relativamente pequeña, puede terminarla rápidamente y permanecer esperando a que otras unidades completen operaciones más complejas.
Perseus analiza estas diferencias y reduce selectivamente la velocidad de los procesadores que terminarían demasiado pronto.
De esta forma, las GPU completan sus trabajos aproximadamente al mismo tiempo.
La ventaja es que los procesadores pueden funcionar con menores frecuencias y, cuando resulta posible, menores tensiones eléctricas, reduciendo su consumo sin prolongar la duración global del entrenamiento.
El principio se relaciona con la gestión dinámica de frecuencia y voltaje, conocida como Dynamic Voltage and Frequency Scaling (DVFS).
En los experimentos de los investigadores, Perseus consiguió reducir el consumo energético hasta un 30 %.
Kareus: reorganizar los cálculos para aprovechar mejor cada GPU
La segunda herramienta, Kareus, aborda un problema más complejo.
Modificar la velocidad de funcionamiento de una GPU también cambia las condiciones óptimas para ejecutar las operaciones informáticas.
Por ejemplo, cuando un procesador trabaja más lentamente, puede resultar conveniente modificar el orden de las tareas, distribuir de otra manera los recursos disponibles o reorganizar las comunicaciones entre chips.
Los programas tradicionales suelen estar optimizados para determinadas condiciones de funcionamiento, frecuentemente próximas al rendimiento máximo del hardware.
Kareus adapta esa planificación a las condiciones reales de cada procesador.
Para conseguirlo, optimiza aspectos como:
- La distribución de núcleos entre operaciones de cálculo y comunicación.
- La ejecución simultánea de determinadas tareas.
- El orden y momento de las transferencias de información.
- El aprovechamiento del ancho de banda y los recursos internos de las GPU.
En las pruebas realizadas con dos grandes modelos de lenguaje de código abierto, la herramienta consiguió reducciones adicionales de consumo energético de entre el 10 % y el 30 %.
La investigación se presentó en julio de 2026 durante el congreso USENIX Symposium on Operating Systems Design and Implementation (OSDI), especializado en sistemas operativos e infraestructura informática.
¿Cuánta electricidad podría ahorrar esta tecnología?
La reducción potencial resulta especialmente relevante cuando se aplica a grandes instalaciones de computación.
Para ilustrar su alcance, puede considerarse un entrenamiento hipotético que actualmente necesite 1.000 MWh de electricidad.
| Escenario | Energía consumida |
|---|---|
| Entrenamiento convencional | 1.000 MWh |
| Con una reducción del 40 % | 600 MWh |
| Con una reducción del 50 % | 500 MWh |
En este ejemplo, el ahorro alcanzaría entre 400 y 500 MWh por entrenamiento.
Estas cifras son una simulación matemática para ilustrar el potencial de la tecnología, no mediciones de una instalación concreta.
Además de reducir la factura eléctrica, una menor demanda energética podría disminuir las emisiones asociadas al entrenamiento, dependiendo de la combinación de fuentes renovables y convencionales utilizadas para suministrar electricidad.
También podría reducir la presión sobre la infraestructura eléctrica y las necesidades de refrigeración, aunque estos beneficios adicionales no se han cuantificado en los resultados publicados.
Es importante distinguir entre reducir la energía consumida por un entrenamiento y reducir el consumo total de un centro de datos. Los porcentajes anunciados corresponden al proceso de entrenamiento y no incluyen necesariamente todos los sistemas auxiliares de las instalaciones.
NVIDIA estudia incorporar la tecnología a Megatron-LM
Uno de los aspectos más relevantes del proyecto es su posible aplicación comercial.
Los investigadores de Michigan están colaborando con NVIDIA para evaluar la integración de sus herramientas en Megatron-LM, una plataforma de código abierto diseñada para entrenar grandes modelos de lenguaje.
Esta infraestructura puede utilizarse directamente o servir como base para desarrollar sistemas personalizados de entrenamiento.
También se emplea en el desarrollo de modelos de la familia Nemotron de NVIDIA.
La investigadora doctoral Ruofan Wu, principal autora del trabajo sobre Kareus, participó durante el verano en las tareas de integración del software.
No obstante, la colaboración todavía se encuentra en fase de evaluación. No se ha anunciado que las optimizaciones estén disponibles de forma generalizada ni que todos los modelos puedan alcanzar el ahorro máximo anunciado.
Los investigadores consideran que los mismos principios podrían aplicarse a otras plataformas de entrenamiento, puesto que los problemas de coordinación entre procesadores no son exclusivos de Megatron-LM.
Una vía para reducir la huella ambiental de la inteligencia artificial
La investigación demuestra que mejorar la eficiencia energética de la inteligencia artificial no depende exclusivamente de desarrollar chips más avanzados.
La gestión del software también puede desempeñar un papel fundamental.
En grandes centros de datos, donde miles de GPU ejecutan operaciones durante periodos prolongados, pequeñas mejoras en la coordinación pueden traducirse en ahorros eléctricos considerables.
Sin embargo, una mayor eficiencia por entrenamiento no garantiza automáticamente una reducción del consumo global de electricidad de la inteligencia artificial.
Si entrenar modelos resulta más barato, las empresas también podrían aumentar la cantidad y el tamaño de los sistemas desarrollados, compensando parcialmente los ahorros conseguidos. Este fenómeno se conoce como efecto rebote.
Además, el trabajo se centra en el entrenamiento de modelos, no en el consumo asociado a su utilización cotidiana para responder consultas, generar imágenes o ejecutar otras tareas de inferencia.
Aun con estas limitaciones, Perseus y Kareus representan una alternativa prometedora para mejorar la sostenibilidad de la infraestructura informática existente.
Su principal ventaja es que permiten realizar el mismo trabajo computacional utilizando menos electricidad, una mejora especialmente importante en un sector cuya demanda energética continúa creciendo.
Fuentes: Universidad de Michigan, 12 de octubre de 2026. Investigación Kareus: Joint Reduction of Dynamic and Static Energy in Large Model Training, presentada en USENIX OSDI 2026.
Deja una respuesta